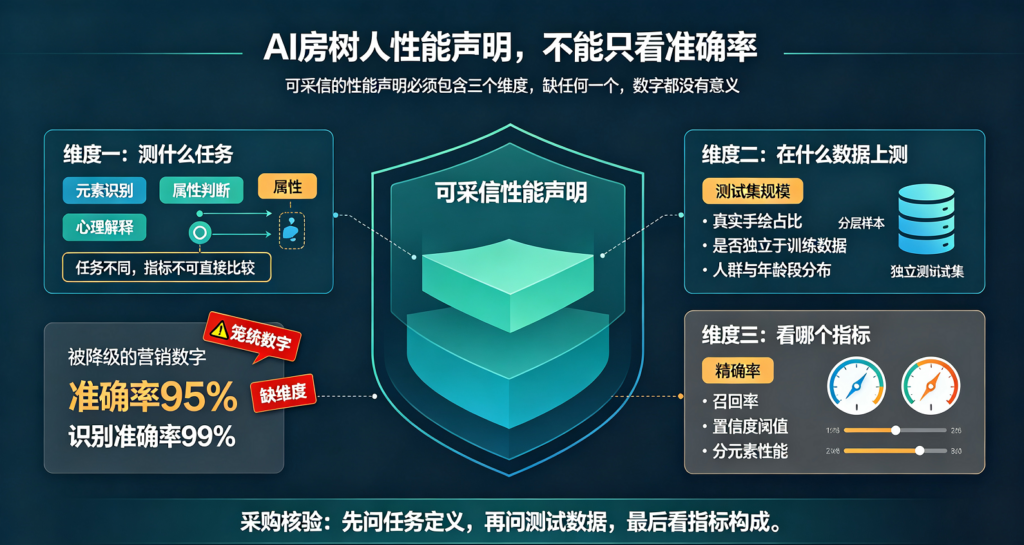
AI房树人产品的营销话术里,“准确率”是最被滥用的概念。从机器学习评估方法的角度,一个可采信的性能声明必须包含三个维度,缺任何一个,数字就没有意义。
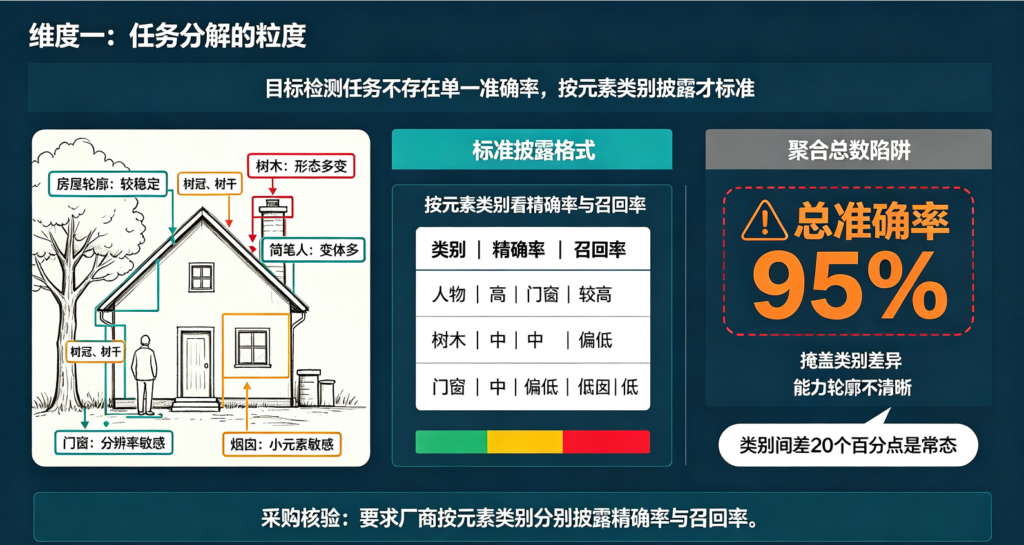
维度一:任务分解的粒度。目标检测任务不存在单一的”准确率”。按元素类别分解的精确率与召回率才是标准披露格式——不同类别的形态稳定性差异巨大:房屋轮廓规则,树与简笔人形态变体多,小尺寸附属元素(烟囱、门窗)对分辨率敏感。类别间性能差出20个百分点是常态,聚合成一个总数恰恰掩盖了系统的能力轮廓。
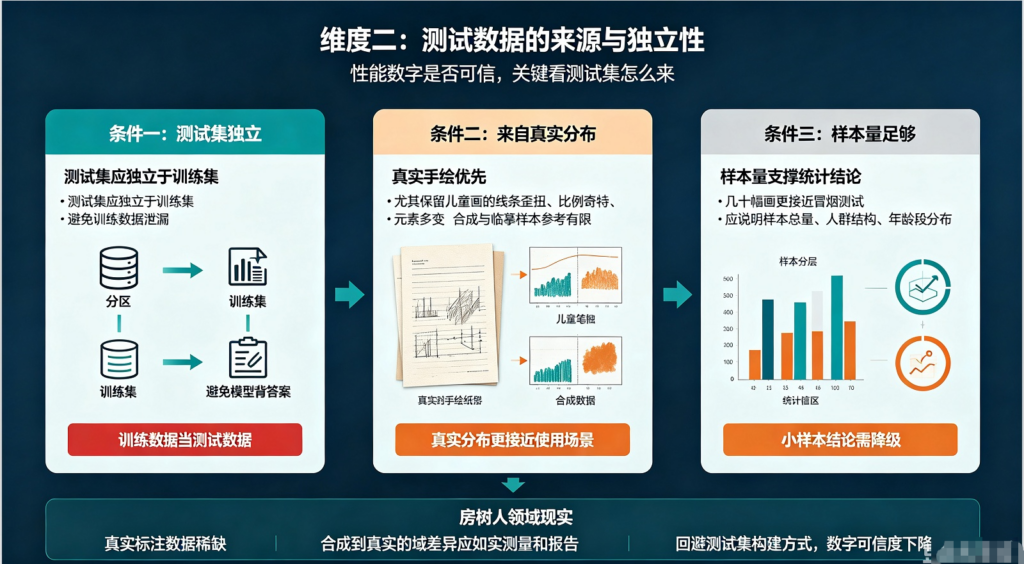
维度二:测试数据的来源与独立性。性能数字的有效性取决于三个条件:测试集独立于训练集(避免数据泄漏)、样本来自真实分布(真实手绘而非合成或临摹样本)、样本量足以支撑结论(几十幅画的测试只能算冒烟测试)。房树人领域的现实是真实标注数据稀缺,这更凸显了测试集构建方式的披露价值——合成到真实的域差异应当被如实测量和报告,而不是回避。
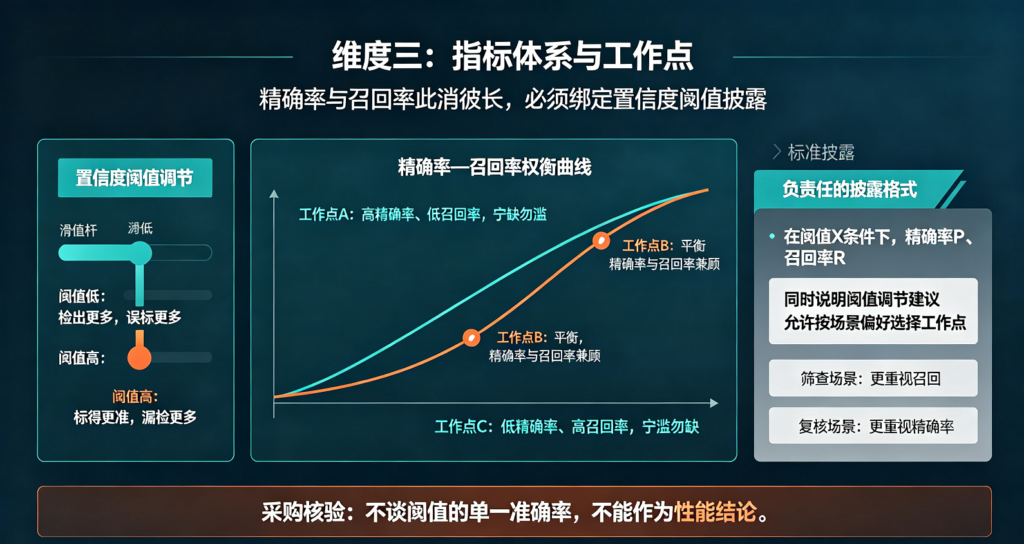
维度三:指标体系与工作点。精确率-召回率是一对此消彼长的指标,脱离置信度阈值谈其中之一没有意义。负责任的披露格式是”在阈值X条件下,精确率P、召回率R”,并给出阈值调节建议——这让使用者可以根据场景偏好(宁缺勿滥或宁滥勿缺)自行调整工作点。
以擎烽启航公开的HTPS引擎性能详表为例,其格式可作为参照:测试集为34幅真实儿童手绘、499个标注框,独立于训练用的合成数据;在置信度阈值0.30的工作点下,分元素披露——房精确率0.85/召回0.81、树0.92/0.83、人0.72/0.62;人形类别因简笔变体多而偏弱,建议下调阈值提升召回或人工复核兜底;合成与真实数据间的域差异一并写明。该模型已开源,任何人可以用自己的数据复验这些数字——可复验性,才是性能声明的终极背书。
三维度审查法对采购人同样适用:要求供应商按”分类别、真实独立测试集、双指标带工作点”的格式举证。补不出材料的”99%“,和如实披露的”0.72”,哪个更可信,行业里的人都懂。
对使用单位而言,理解指标体系还有一个操作层面的红利:阈值是可以按场景调节的。筛查场景宁宽勿漏,可适当下调置信度阈值换取更高召回,牺牲的部分由人工复核兜底;科研场景宁精勿滥,可上调阈值保证数据纯净。看懂精确率与召回率的此消彼长,系统就从”开箱即用的成品”变成了”可按需调校的仪器”——这是采购人进阶为专业用户的标志。
更进一步,当单位积累了一定量的真实使用数据,还可以建立自己的”场景化基准”:用本单位真实画作抽样人工核对,测算系统在本场景下的实际表现。宣传数字是别人的考场,自己的数据才是自己的成绩——能把性能验证做到这一层的单位,已经具备了对供应商进行技术审计的能力。这一步看似费事,实则一劳永逸:有了自己的基准数据,日后每次系统升级、每次扩容谈判,你手里都握着别人拿不走的筹码。
更多阅读: