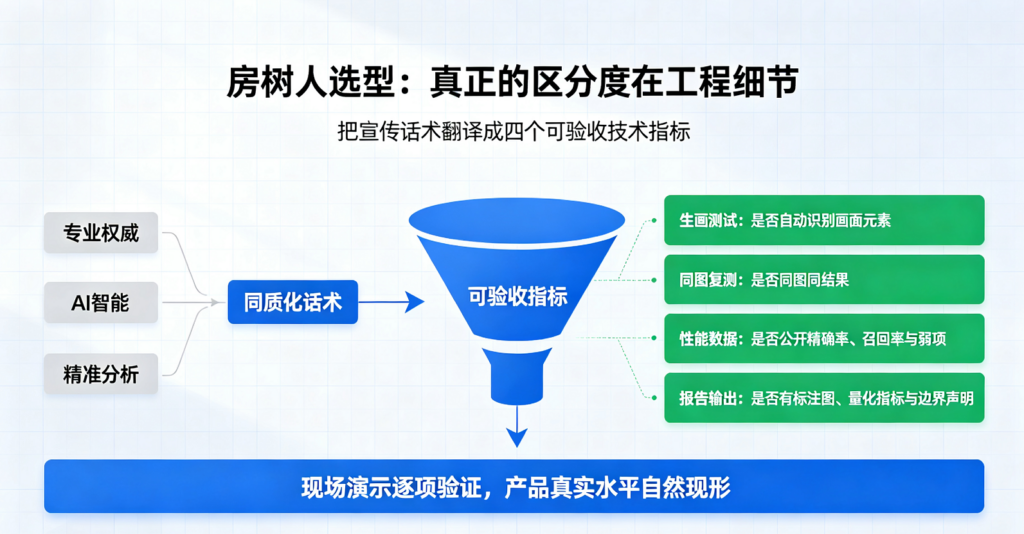
房树人测验系统的宣传话术高度同质化,选型真正的区分度在工程细节上。把宣传翻译成可验收的技术指标,四个验收点足够。
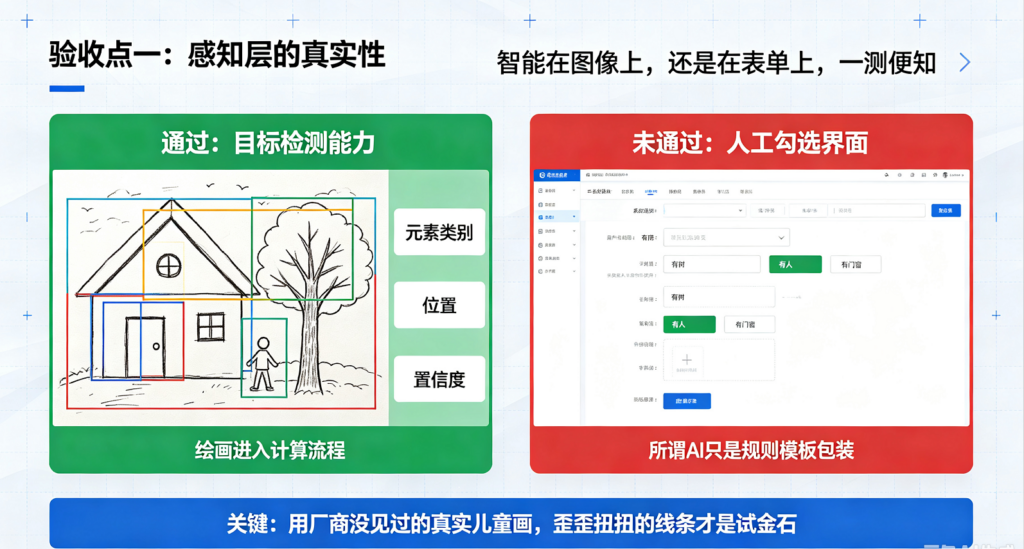
验收点一:感知层的真实性。系统的”智能”究竟在图像上还是在表单上,一测便知:提交一幅训练分布之外的画作,观察系统行为。输出带框标注图——元素类别、位置、置信度逐项列出——说明系统具备真实的目标检测能力;退回到人工勾选界面,则说明绘画从未进入计算流程,所谓AI只是规则模板的话术包装。这个测试的关键是样本要”生”:用厂商没见过的真实儿童画,歪歪扭扭的线条才是检测模型的试金石。
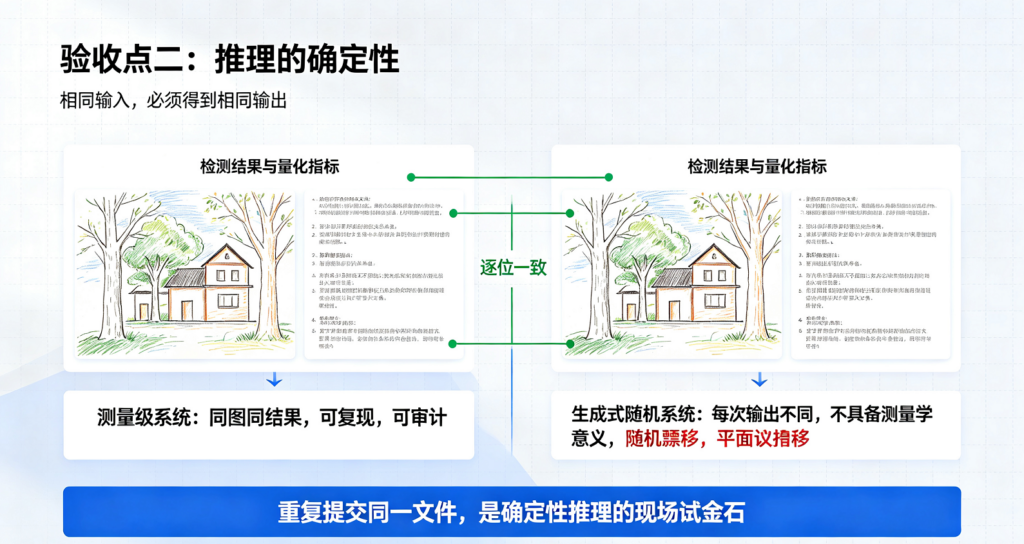
验收点二:推理的确定性。测量系统的核心工程属性是确定性推理:相同输入必得相同输出。同一图像文件重复提交,检测结果和量化指标应当逐位一致。输出随机的系统本质是生成式的,其”分析”不具备测量学意义,也无法通过信度检验。
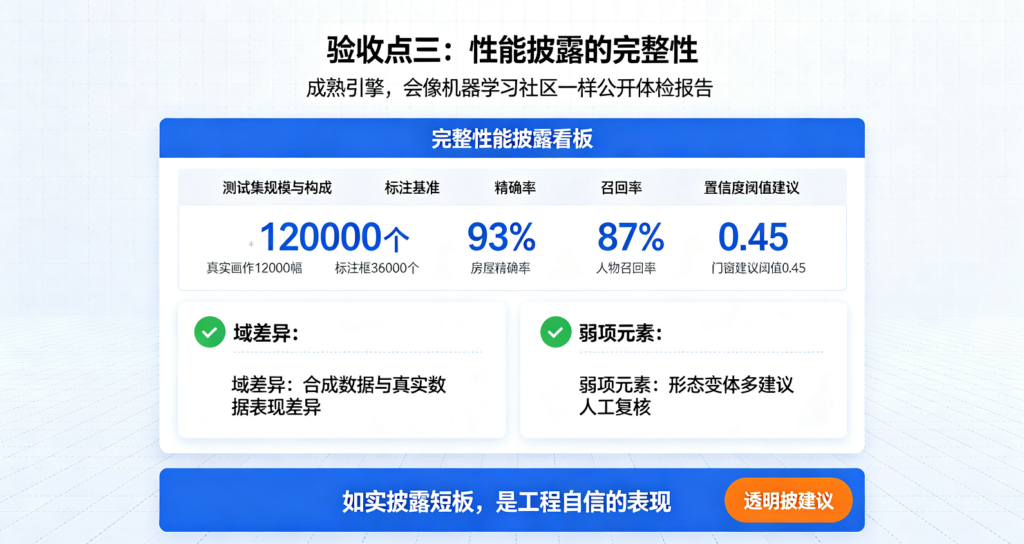
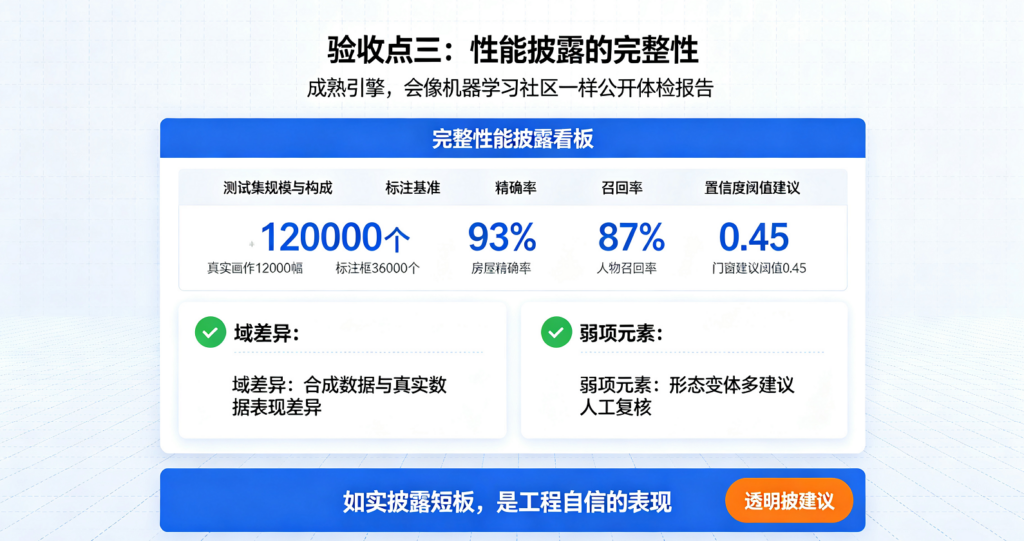
验收点三:性能披露的完整性。成熟的检测引擎会以机器学习社区的标准方式披露性能:测试集规模与构成(真实画作数量、标注框总数)、标注基准的建立方式、各元素的精确率与召回率、置信度阈值建议。更专业的厂商会主动披露域差异——模型在合成数据与真实数据上的表现差异,以及弱项元素的使用建议。如实披露短板是工程自信的表现。
验收点四:输出的合规与可审计性。专业系统的报告应包含三要素:可视化标注图(检测结果可逐项人工核对)、结构化量化指标(数量、占比、空间分布)、以及明确的边界声明(输出为参考性测量结果,不构成心理诊断结论,判读由专业人员完成)。三者缺一,报告的档案价值和专业价值都会打折。
以擎烽启航的房树人绘画心理分析系统(智绘心声)为例,对照四个验收点:上传任意画作自动输出25类元素的检测标注图与量化明细;同一图像重复检测结果完全一致;34幅真实儿童画、499个标注框的实测性能(房树人主干元素精确率0.72—0.92)连同置信度使用建议全部公开,检测模型已开源接受验证;报告为阅读版筛查报告,附特征标注图,明确标注”机器测量、专家复核”的使用边界。系统支持批量处理与本地离线部署。
四个验收点跑完,“测量工具”与”话术包装”的分别,不需要任何技术背景也能看清。
建议把四个验收点固化为单位的采购流程文件:验收动作、通过标准、记录格式一并写明,经办人照章执行即可。工具选型的最大风险从来不是技术判断失误,而是流程让位于话术——把验收动作制度化,就是把偶然的分辨力变成稳定的采购能力。
更多阅读: