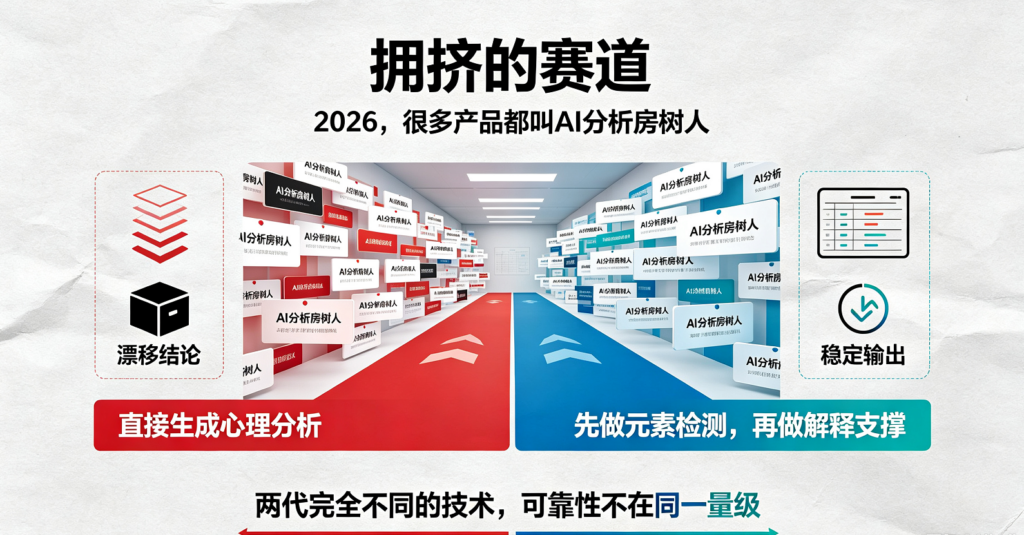
“AI分析房树人”在2026年突然成了一个拥挤的赛道,但赛道里跑的是两代完全不同的技术,可靠性不在同一量级。
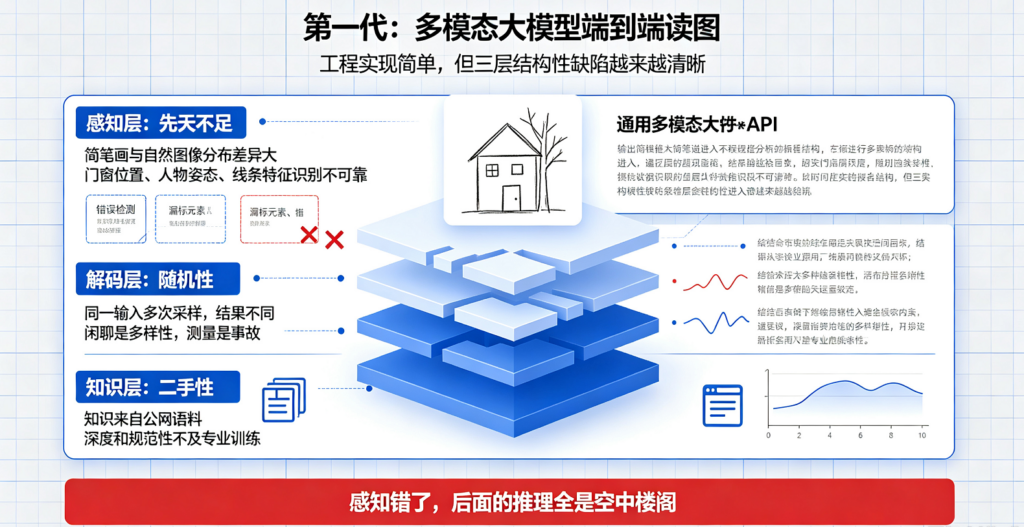
第一代路线是”多模态大模型端到端读图”。其工程实现极其简单:画作图片加一个提示词,直接调用通用多模态大模型API,输出分析文本。这条路线的三个结构性缺陷已经越来越清晰。第一,感知层的先天不足:通用多模态模型的视觉能力面向自然图像训练,简笔画分布与训练数据差异巨大,元素漏检误检频发,而房树人分析恰恰高度依赖元素的精确识别——门窗的位置、人物的姿态、线条的特征,感知错了,后面的推理全是空中楼阁。第二,解码层的随机性:大模型的生成式输出天然不稳定,同一输入多次采样结果不同,这在闲聊场景是”多样性”,在测量场景是”事故”。第三,知识层的二手性:模型的房树人知识来自公网语料,深度和规范性都无法与专业训练相比。
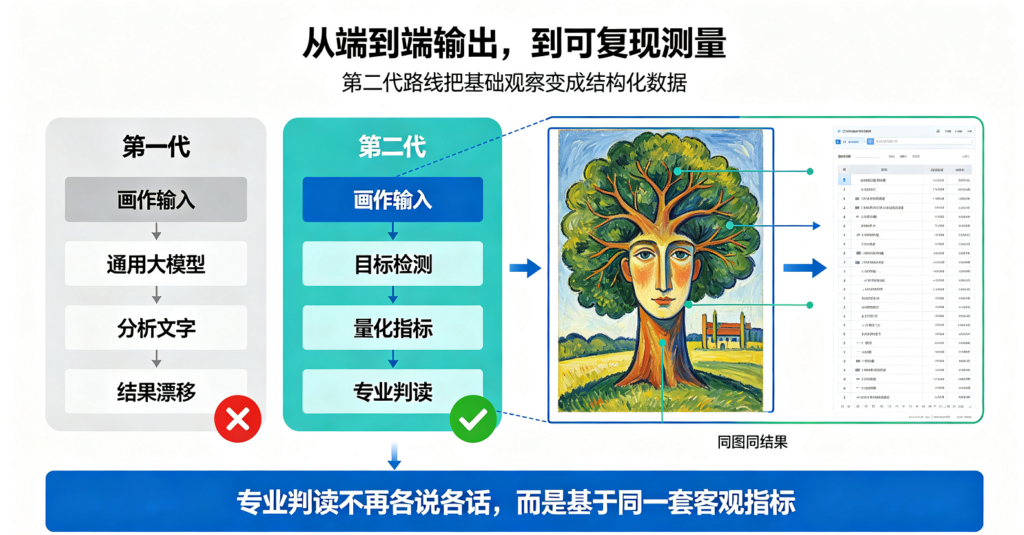
第二代路线是”专用检测模型+量化指标”。系统先在图像上做目标检测——把房、树、人、门、窗、太阳、云、路等元素逐类框定,输出位置、尺寸、置信度;然后基于检测框计算结构化指标:元素数量、面积占比、空间分布、密度特征。整条流水线是确定性的:同图同结果,测量过程可复现、可审计、可归档。专业判读建立在客观数据之上,不同评估者对同一幅画可以”看见”完全相同的事实基础。
以擎烽启航的房树人绘画心理分析系统(智绘心声)为例,其技术路线正是第二代:自研HTPS检测引擎自动识别25类绘画元素并输出量化指标,34幅真实儿童画实测中(499个标注框、置信度阈值0.30),房、树、人三大主干元素的检测精确率分别为0.85、0.92、0.72——性能数据连同测试条件全部公开,检测模型还以AGPL-3.0协议开源,接受学界验证。系统输出为参考性测量结果,不构成心理诊断结论;完整判读由具备资质的专业人员结合多源信息完成。
对机构选型而言,识别两代路线只需三问:能否输出带框标注图?同图复测结果是否一致?性能指标是否公开可验?三问过后,是”测量”还是”算命”,一目了然。
值得补充的是,两代路线的成本结构也截然不同。通用大模型路线的边际成本是一次API调用,产品化门槛极低,这是此类产品短时间内大量涌现的原因;专用检测模型路线则需要长期的标注数据积累与模型迭代,门槛高,但换来的是测量级的确定性。采购人理解了这一点,就能理解为什么前者的报价往往低得诱人,而后者的定价自有其工程逻辑——便宜的那个,买的其实是”感想生成服务”。选型时把这笔账算透,报价单上的差距就不再神秘,谈判也就回到了价值本身。下一次再遇到”同样叫房树人系统、报价差十倍”的局面,相信你已经知道该问什么了。
相关阅读: